Kafka
Lagern Sie Kafka-Topic-Daten mit dem Kafka-Connect-S3-Sink-Connector nach RustFS aus.
In dieser Anleitung verbinden Sie Apache Kafka — die verteilte Event-Streaming-Plattform — über den Kafka-Connect-S3-Sink-Connector mit RustFS. Sie betreiben einen KRaft-Broker und einen Connect-Worker, stellen den S3-Sink für ein Topic bereit und produzieren Datensätze, die als Objekte in einem RustFS-Bucket landen. Der Ablauf wurde mit apache/kafka:4.0.0 und confluentinc/kafka-connect-s3 v10.5.25 gegen rustfs/rustfs-x86-musl:v2.3.1 verifiziert.
Die gestufte Speicherung nach Kafka KIP-405 benötigt ein Plugin RemoteLogStorageManager, und die S3-Implementierungen im Ökosystem sind herstellerspezifisch. Der Connect-S3-Sink ist der offene, selbst gehostete Weg, Topic-Daten in S3-kompatiblen Speicher zu verschieben, und ist der hier dokumentierte Ansatz.
Sie benötigen Docker. Diese Bereitstellung ist für lokale Integrationstests gedacht, nicht für den Produktivbetrieb.
Architektur
Der Sink-Task konsumiert ein Topic in einer eigenen Consumer-Gruppe und schreibt Datensatzstapel in den Bucket, ein Objekt je flush.size Datensätze je Partition.
Den Broker starten
Starten Sie einen KRaft-Broker, dessen angekündigter Listener von anderen Containern aus erreichbar ist:
docker run -d --name kafka --hostname kafka --network oo-rustfs_default \
  -e CLUSTER_ID=5L6g3nShT-eMCtK--X86sw \
  -e KAFKA_NODE_ID=1 \
  -e KAFKA_PROCESS_ROLES=broker,controller \
  -e KAFKA_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093 \
  -e KAFKA_ADVERTISED_LISTENERS=PLAINTEXT://kafka:9092 \
  -e KAFKA_CONTROLLER_LISTENER_NAMES=CONTROLLER \
  -e KAFKA_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT \
  -e KAFKA_CONTROLLER_QUORUM_VOTERS=1@kafka:9093 \
  -e KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR=1 \
  -e KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR=1 \
  -e KAFKA_TRANSACTION_STATE_LOG_MIN_ISR=1 \
  apache/kafka:4.0.0

docker exec kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 \
  --create --topic rustfs-topic --partitions 1 --replication-factor 1

rc mb rustfs/kafka-demo
Das Image kündigt standardmäßig localhost:9092 an, was nur aus dem Broker-Container heraus funktioniert. Die Überschreibung KAFKA_ADVERTISED_LISTENERS macht den Broker für Connect und jeden entfernten Client erreichbar.
Den Connector installieren
Laden Sie das Confluent-Hub-Archiv herunter, das den Connector und seine Abhängigkeiten bündelt, und entpacken Sie es dort, wo der Worker es sieht:
curl -Lo kafka-connect-s3.zip "https://hub-downloads.confluent.io/api/plugins/confluentinc/kafka-connect-s3/versions/10.5.25/confluentinc-kafka-connect-s3-10.5.25.zip"
unzip kafka-connect-s3.zip -d /opt/kafka-conn/plugins
Worker und Sink konfigurieren
Legen Sie die Worker-Properties an. Der Value-Converter muss ByteArrayConverter sein, damit Datensätze unverändert geschrieben werden:
bootstrap.servers=kafka:9092
key.converter=org.apache.kafka.connect.storage.StringConverter
value.converter=org.apache.kafka.connect.converters.ByteArrayConverter
offset.storage.file.filename=/tmp/connect.offsets
offset.flush.interval.ms=5000
plugin.path=/opt/kafka-conn-plugins
Legen Sie die Konfiguration des Sink-Connectors an und ersetzen Sie alle Verbindungsplatzhalter:
name=rustfs-sink
connector.class=io.confluent.connect.s3.S3SinkConnector
tasks.max=1
topics=rustfs-topic
s3.bucket.name=kafka-demo
s3.region=us-east-1
store.url=http://<your-rustfs-endpoint>:9000
s3.path.style.access.enabled=true
flush.size=3
storage.class=io.confluent.connect.s3.storage.S3Storage
format.class=io.confluent.connect.s3.format.bytearray.ByteArrayFormat
consumer.override.auto.offset.reset=earliest
Kafka 4.0 hat die Klasse nach org.apache.kafka.connect.converters.ByteArrayConverter verschoben. Der alte Paketpfad storage lässt sich nicht mehr auflösen.
Den Worker starten
Führen Sie connect-standalone im Vordergrund aus, damit die Logs in docker logs landen, und setzen Sie die Bucket-Zugangsdaten in der Umgebung:
docker run -d --name kafka-connect --hostname kafka-connect \
  --network oo-rustfs_default \
  -v /opt/kafka-conn/plugins:/opt/kafka-conn-plugins:ro \
  -v "$PWD/worker.properties":/etc/kafka/worker.properties:ro \
  -v "$PWD/rustfs-sink.properties":/etc/kafka/sink.properties:ro \
  -e AWS_ACCESS_KEY_ID=<your-access-key> \
  -e AWS_SECRET_ACCESS_KEY=<your-secret-key> \
  apache/kafka:4.0.0 \
  /opt/kafka/bin/connect-standalone.sh /etc/kafka/worker.properties /etc/kafka/sink.properties
Der Worker ist bereit, wenn der Sink-Task die Partition beansprucht:
INFO [rustfs-sink|task-0] Assigned topic partitions: [rustfs-topic-0]Datensätze produzieren
Senden Sie mindestens flush.size Datensätze, damit der Connector einen Stapel abschließt:
docker exec kafka sh -c "printf 'msg-one\nmsg-two\nmsg-three\n' | \
  /opt/kafka/bin/kafka-console-producer.sh --bootstrap-server localhost:9092 --topic rustfs-topic"
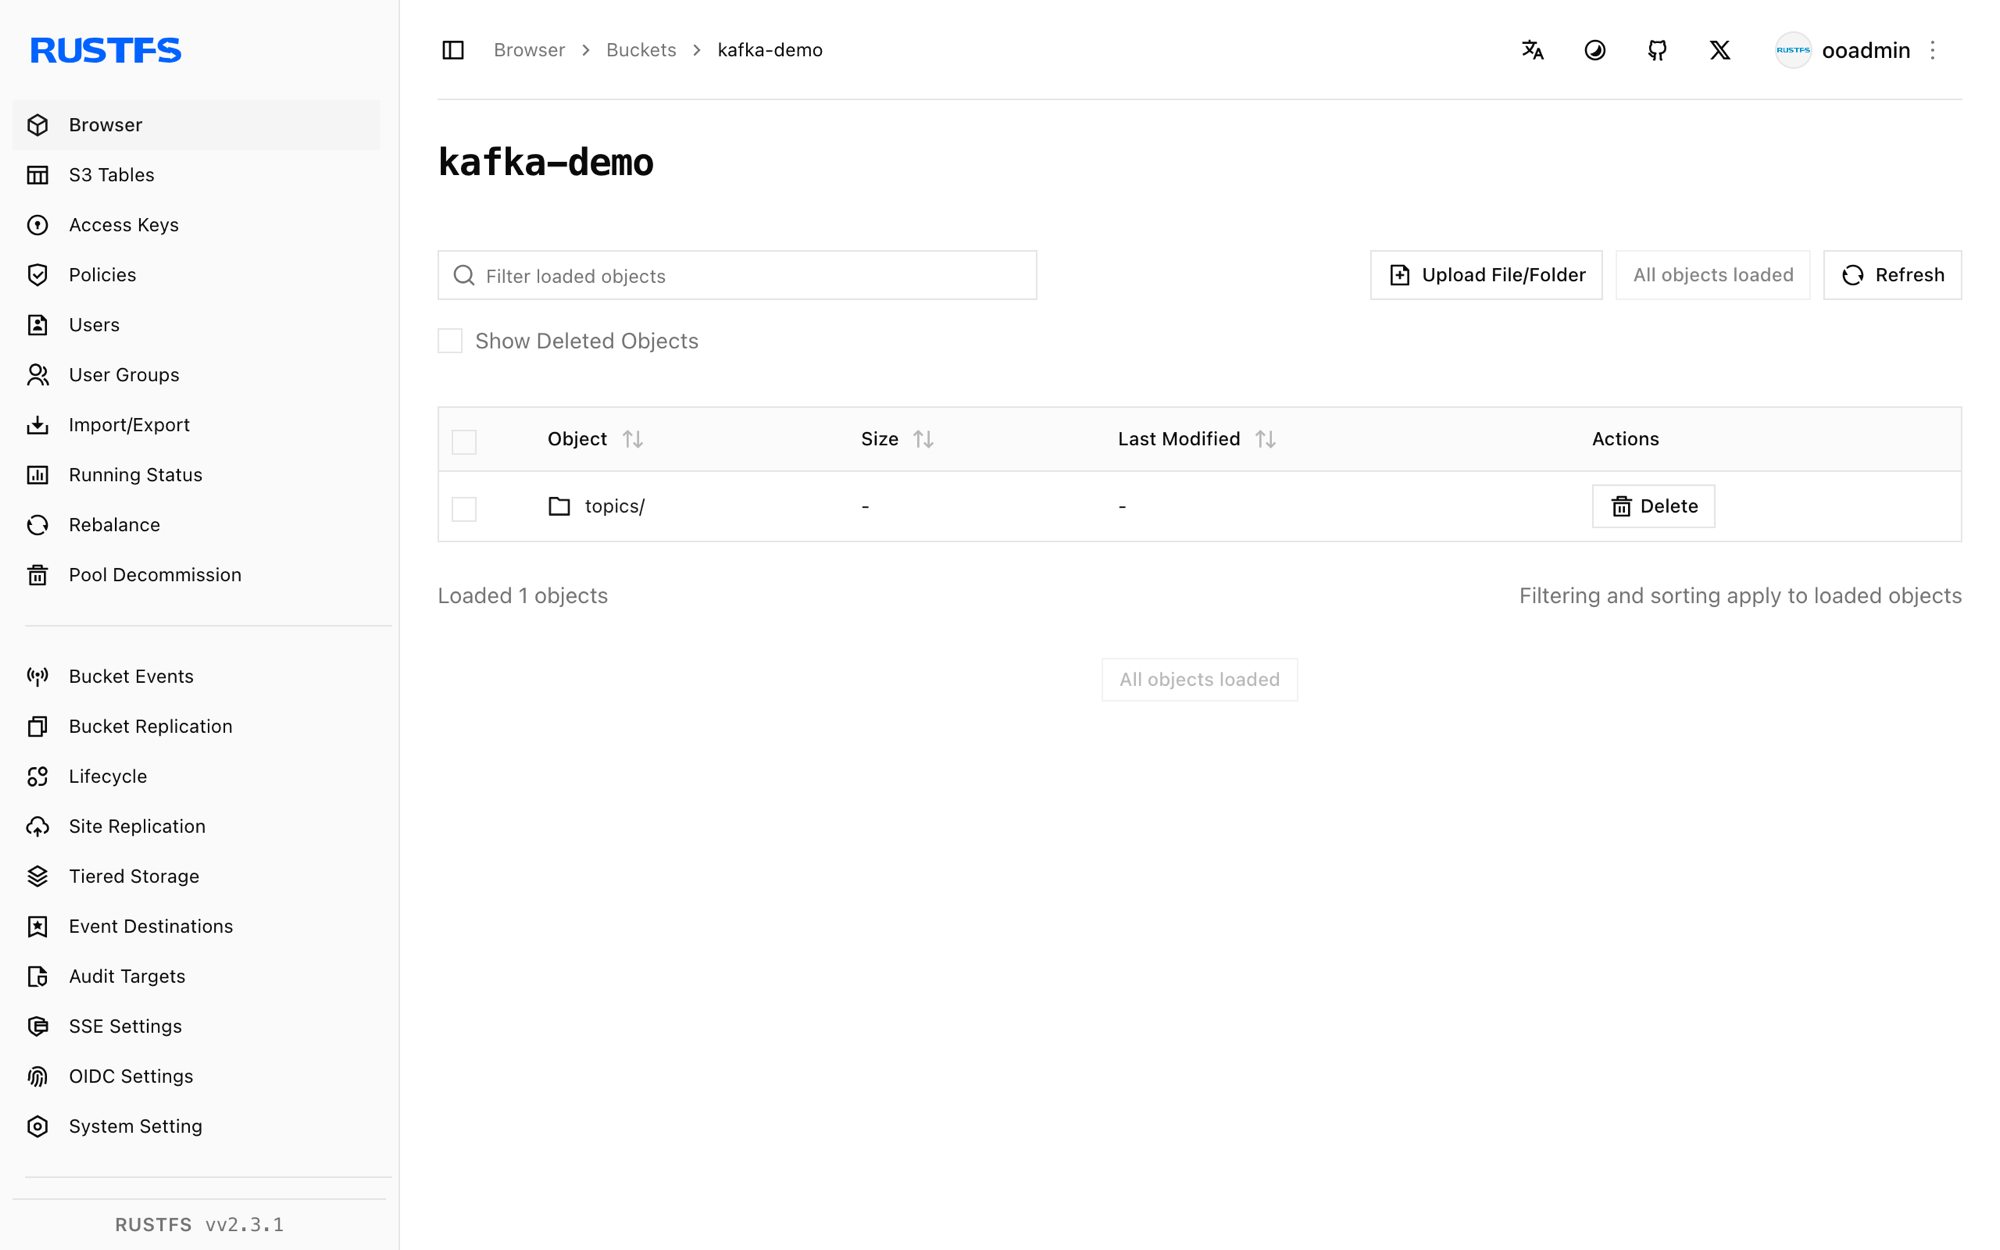
Nach einigen Sekunden wird der Stapel zu einem Objekt im Bucket:
rc ls rustfs/kafka-demo/ -r
rc cat rustfs/kafka-demo/topics/rustfs-topic/partition=0/rustfs-topic+0+0000000000.bintopics/rustfs-topic/partition=0/rustfs-topic+0+0000000000.bin
topics/rustfs-topic/partition=0/rustfs-topic+0+0000000003.bin
msg-one
msg-two
msg-threeDer Objektname kodiert Topic, Partition und Start-Offset. Jeder folgende Stapel von drei Datensätzen landet im nächsten Objekt (+0000000003.bin und so weiter).
Stoppen oder zurücksetzen
Um die Demo abzubauen und die Bucket-Objekte zu behalten:
docker rm -f kafka-connect kafkaUm die gespeicherten Daten zu löschen:
rc rm rustfs/kafka-demo/ --recursive --forceFehlerbehebung
AdminClient ... Rebootstrapping with Cluster (id: null) läuft endlos
Der Broker kündigt localhost:9092 an, daher erhält ein entfernter Client Metadaten, die auf ihn selbst zeigen. Setzen Sie KAFKA_ADVERTISED_LISTENERS=PLAINTEXT://kafka:9092 und die passenden Listener-Variablen wie in Schritt 1.
Invalid schema type for ByteArrayConverter: STRING
Der Writer ByteArrayFormat akzeptiert nur Rohbytes. Stellen Sie entweder den value.converter des Workers auf den ByteArray-Converter um oder wählen Sie eine Formatklasse, die zu dem Converter passt, den Sie verwenden.
Class org.apache.kafka.connect.storage.ByteArrayConverter could not be found
Kafka 4.0 hat die Klasse nach org.apache.kafka.connect.converters.ByteArrayConverter verschoben. Verwenden Sie den neuen Paketpfad in worker.properties.
Der Connector wird heruntergeladen, das Plugin wird aber nicht gefunden
Das reine Connector-JAR von Maven enthält seine Abhängigkeiten nicht. Verwenden Sie das Confluent-Hub-Archiv aus Schritt 2, das das vollständige Verzeichnis lib/ bündelt, und stellen Sie sicher, dass plugin.path auf das Verzeichnis zeigt, das den Connector-Ordner enthält.
Nächste Schritte
- Lesen Sie die S3-Kompatibilitätshinweise, bevor Sie weitere Connectoren einsetzen.
- Erstellen Sie dedizierte Produktions-Zugangsdaten über die Zugriffsschlüssel-Verwaltung.
- Folgen Sie der Dokumentation zum Kafka-Connect-S3-Sink für die Formate Parquet und Avro, die Partitionierung nach Zeit und Zugangsdatenketten auf IAM-Basis.